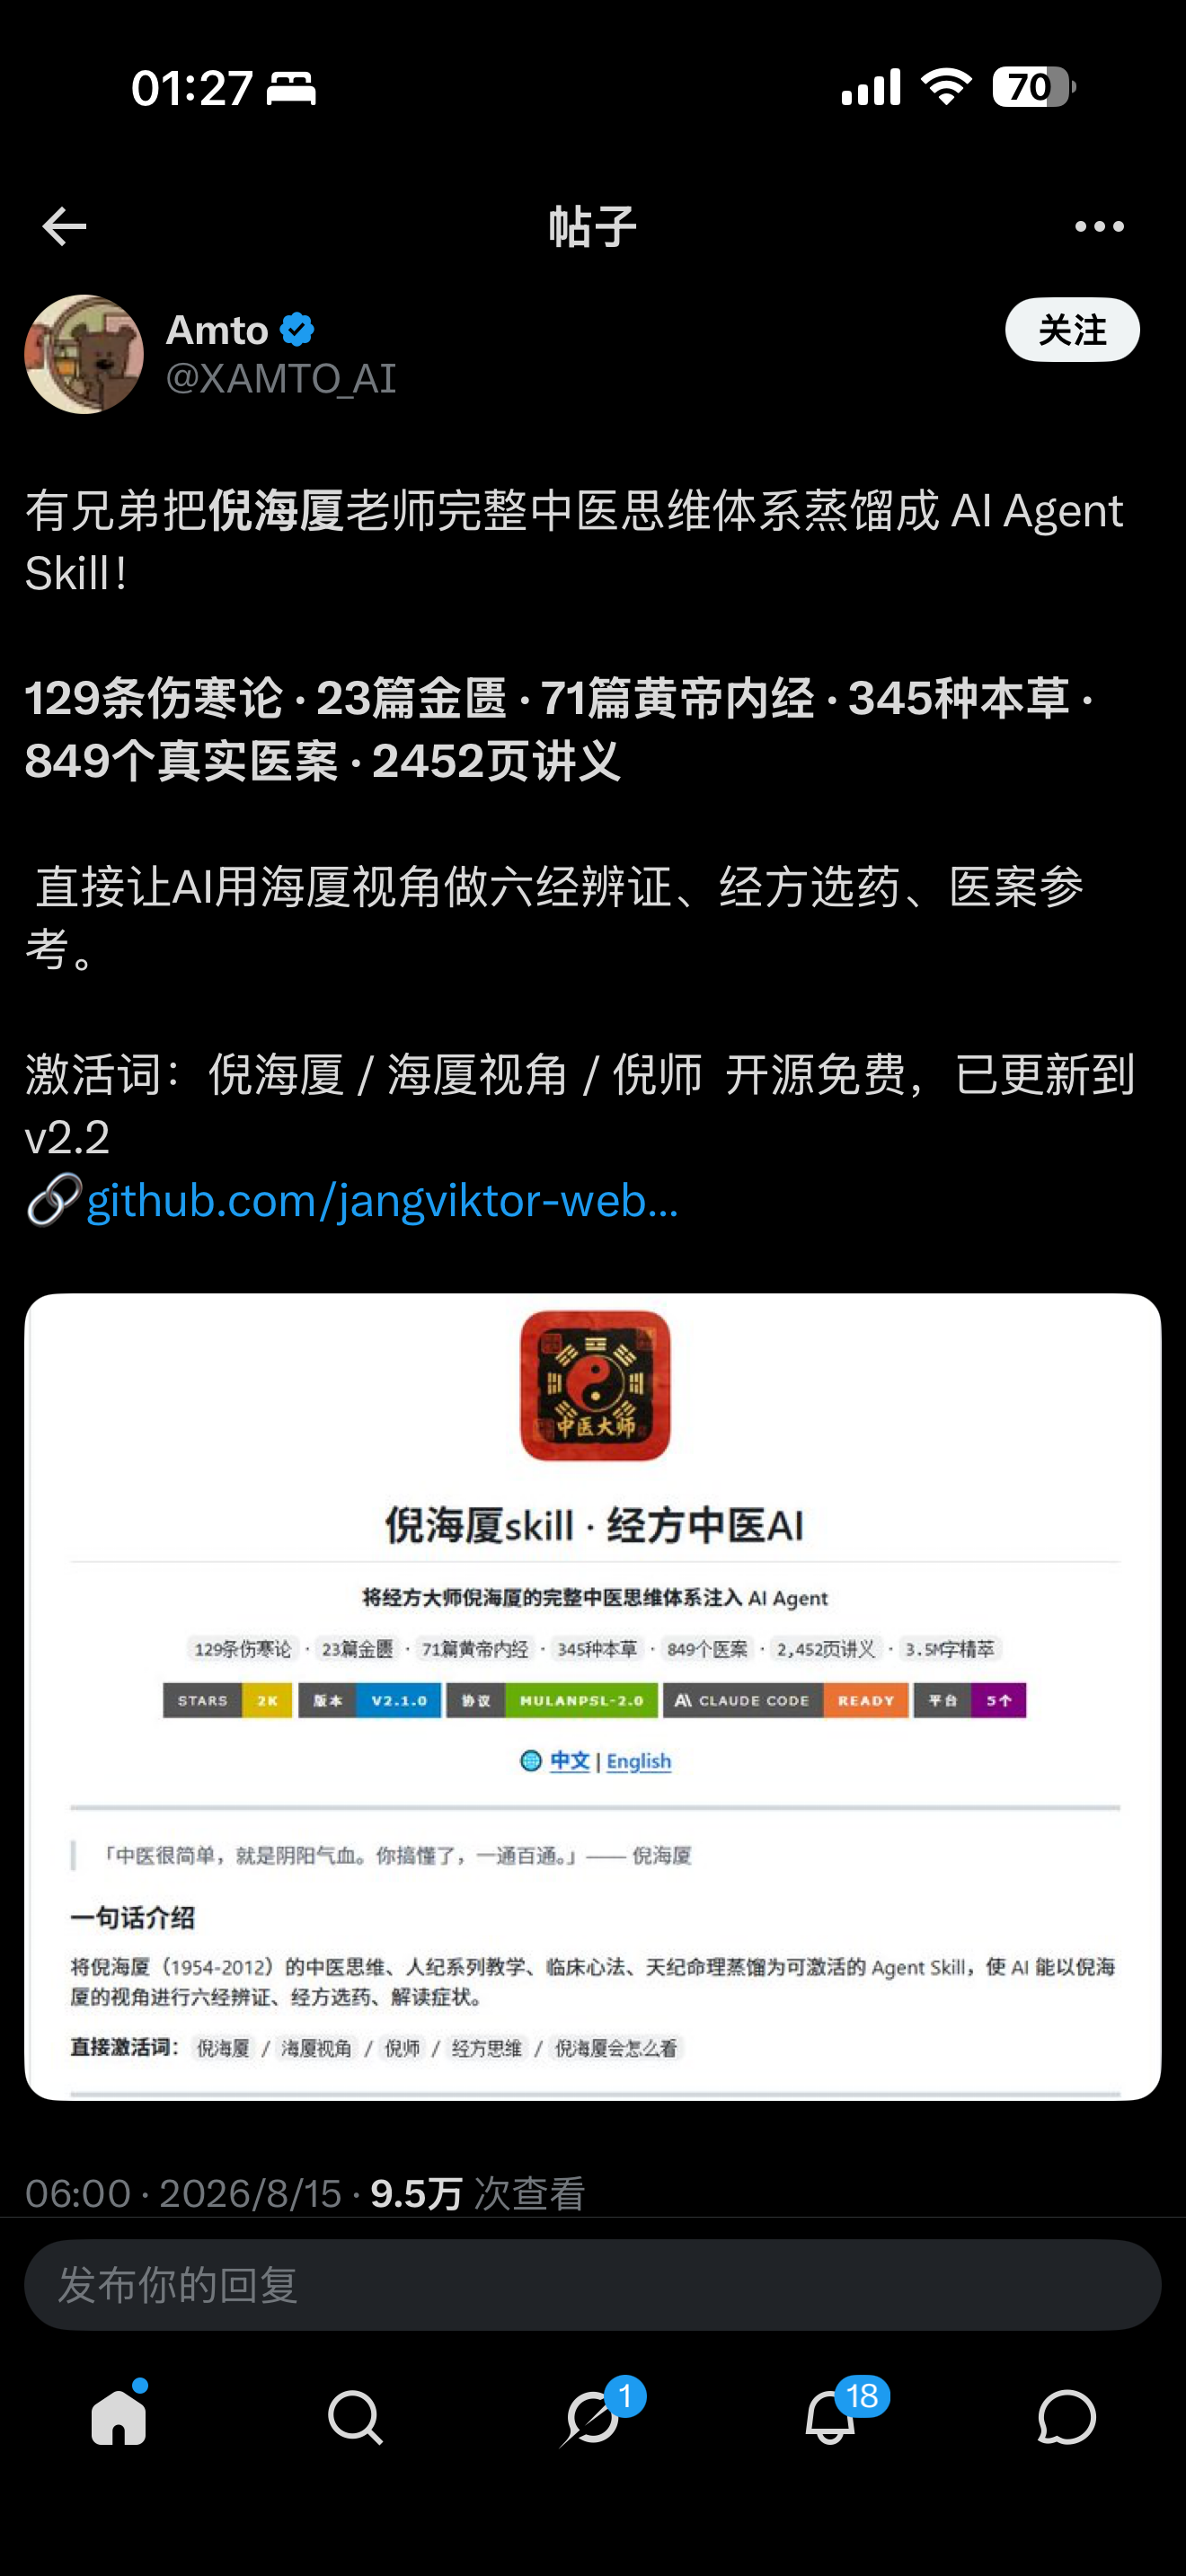
我最近开始思考,这种炼化万物的能力到底是怎么做到的,比如前段时间很地狱的“张雪峰SKILL”,我在想难道万物都可以炼化吗?这些到底是怎么做到的呢?
什么是Skill?
首先,既然要做成标准的能力,就需要像MCP一样,采用一种通用的标准,Agent Skills 应运而生,这种格式最初由 Anthropic 开发,作为开放标准发布,并已被越来越多的智能体产品采用。该标准向更广泛的生态系统开放,欢迎各方贡献,它定义了一种轻量级、开放式的格式,用于通过专业知识和流程扩展AI Agent的能力,能够指导AI Agent如何执行特定任务的指令。
AI Agant通过渐进式披露加载技能,分为三个阶段:
- 发现 :启动时,智能体仅加载每个可用技能的名称和描述,足以判断何时可能相关。
- 激活 :当任务与技能描述匹配时,智能体会将完整的
SKILL.md指令读入上下文。 - 执行 :智能体按照指令操作,必要时可选择执行捆绑的代码或加载引用的文件。
完整指令仅在任务需要时加载,因此智能体可以随身携带大量技能,而只需占用很小的上下文空间。
如何做Skill?
要真正做到“炼化万物为 Skill”,不能把它理解成一个“大模型总结器”,而应该把它设计成一条知识编译流水线,当前大模型的多模态理解能力还远没有达到一键生成SKILL的地步,而且SKILL也随着知识体系的加深正变得越来越复杂。
制作Skill的步骤大致分为:
- 原始多模态资料
- 标准化语料
- 知识 IR(重要)
- 知识体系
- Skill 编译
- 评测(重要)
- Agent Runtime
整体思路
PDF / Word / 网页 / 图片 / 音频 / 视频
                    ↓
              Parser / OCR / ASR
                    ↓
             Canonical Document
                    ↓
             Knowledge Extraction
                    ↓
                Knowledge IR
                    ↓
           Normalize / Merge / Link
                    ↓
              Knowledge Package
                    ↓
              Skill Compiler
                    ↓
         SKILL.md + references + tools
                    ↓
Agent Runtime简单来说就是这样:将很多非结构的东西比如文档、图像、音频,先全部转为结构的内容,比如txt、json、md,然后通过一种手段将他们转为一套体系化的手册,里面的内容通过目录关联起来,然后通过mcp、function calling等方式提供给大语言模型调用
Raw Source
↓
Normalized Document
↓
Knowledge IRRaw Source 知识来源可以是以下这些:
PDF
Word
PPT
Excel
Markdown
TXT
HTML
网页
图片
扫描件
音频
视频
数据库
API
Git 仓库那就需要针对不同的东西,用不同的方法来整理知识了,常见技术如下:
| 类型 | 技术 |
|---|---|
| PyMuPDF、PDFBox | |
| Word | Apache POI、python-docx |
| Excel | Apache POI、openpyxl |
| PPT | Apache POI、python-pptx |
| 通用文件 | Apache Tika |
| HTML | Jsoup、BeautifulSoup |
| Markdown | CommonMark |
| EPUB | ebooklib 等 |
例如《伤寒论.pdf》:
伤寒论.pdf
↓
PDF Parser
↓
文字 + 页码 + 标题 + 段落不能只提取:
太阳之为病,脉浮……最好保留:
{
  "documentId": "shanghan_001",
  "page": 12,
  "heading": "辨太阳病脉证并治",
  "paragraph": 7,
  "text": "太阳之为病,脉浮……"
}因为后面所有知识必须能追溯回来。
多模态归一化
这是不同媒介 → 标准语料的步骤,目的是将多种模态的知识转为统一格式的知识,以便后续建立完整的知识体系。
图片
第一种是OCR(图像文字识别),这种适合文字,比如:
扫描医书
↓
OCR
↓
文字可选:
PaddleOCR
Tesseract
云 OCR第二种是VLM(视觉模型),如果图片本身存在视觉语义:
舌象照片
穴位图
流程图
表格
药材照片就不能只 OCR。需要视觉模型:
Image
↓
Vision Language Model
↓
结构化描述例如:
{
  "type": "tongue_image",
  "observations": [
    "舌苔白",
    "舌体偏淡"
  ]
}但医学领域尤其要注意:模型生成的视觉描述必须和原始图片绑定,不能自动当成医学事实。
音频和视频
音频:
讲课录音
↓
ffmpeg
↓
音频标准化
↓
ASR
↓
Transcript技术可以使用:
Whisper
Whisper 类模型
云端语音识别最好带:
{
  "start": 123.5,
  "end": 142.8,
  "speaker": "倪海厦",
  "text": "……"
}视频:
视频
├── 音频 → ASR
└── 关键帧 → VLM / OCR最终合并:
00:32:10 老师讲话……
00:32:15 PPT:桂枝汤……
00:32:21 老师指向某张图……所以视频处理实际上是时序多模态融合。
总结范文
这一步非常重要,不同输入最终应该统一成一个内部文档模型,而不是:
PDF 一套逻辑
音频一套逻辑
网页一套逻辑例如:
{
  "documentId": "lecture_0001",
  "sourceType": "VIDEO",
  "title": "伤寒论课程第一讲",
  "author": "xxx",
  "sections": [
    {
      "sectionId": "s001",
      "title": "太阳病",
      "blocks": [
        {
          "blockId": "b001",
          "type": "TEXT",
          "content": "...",
          "locator": {
            "startTime": 124.5
          }
        }
      ]
    }
  ]
}我会把这一层称为:
Canonical Document Model它相当于编译器的 AST 前置层。
分块(Chunking)
现在才进入 LLM。
首先不能一次把几百万字扔进去。
需要切块。
但不能简单:
text.substring(0, 10000)更合理是:
Document
↓
章节
↓
小节
↓
语义段
↓
ChunkChunk 应该保留上下文
例如:
{
  "chunkId": "shanghan-12-03",
  "titlePath": [
    "伤寒论",
    "辨太阳病脉证并治"
  ],
  "text": "...",
  "previousChunk": "...",
  "nextChunk": "...",
  "source": {
    "page": 12
  }
}Chunking 技术
可以组合:
Heading based
Paragraph based
Token based
Semantic splitting
Sliding window我建议:
结构优先,token 限制兜底。
即:
章节边界
>
段落边界
>
语义边界
>
Token 强制切割而不是纯 token 切割。
知识抽取
这里才是真正开始“炼”。
以前:
一大段自然语言经过 LLM 后应该变成:
概念
事实
规则
流程
案例
关系
术语
条件
例外这一步叫:
Information Extraction / Knowledge Extraction
知识转义(IR)
Knowledge IR 通常指的是 Knowledge Intermediate Representation(知识中间表示层),这是整个平台最核心的数据结构。
Source
↓
LLM
↓
Knowledge IR
↓
Skill我们不应希望让模型输出 Markdown。而是希望应该输出自然语言。
一个知识节点:
{
  "id": "K-000001",
  "type": "RULE",
  "subject": "太阳病",
  "predicate": "possible_symptom",
  "object": "脉浮",
  "conditions": [],
  "confidence": 0.91,
  "sources": [
    {
      "documentId": "shanghan",
      "page": 12,
      "chunkId": "chunk-37"
    }
  ]
}比如方剂:
{
  "id": "FORMULA-001",
  "type": "FORMULA",
  "name": "桂枝汤",
  "ingredients": [
    {
      "name": "桂枝",
      "amount": "三两"
    }
  ],
  "sources": [...]
}比如案例:
{
  "type": "CASE",
  "presentation": [],
  "diagnosis": [],
  "treatment": [],
  "outcome": [],
  "sources": []
}为什么 IR 如此重要
假设以后用户不再要:
Claude Skill而是要:
ChatGPT
Gemini
MCP
RAG
知识图谱
API
网页知识库如果你的核心存储是:
SKILL.md你就寄了。
因为 Skill 是:
编译产物。
而 Knowledge IR 才是:
源资产。
正确关系:
                 ┌→ Claude Skill
                 │
Knowledge IR ────┼→ MCP Server
                 │
                 ├→ RAG Index
                 │
                 ├→ Knowledge Graph
                 │
└→ Wiki这点是我最建议你坚持的架构原则。
IR 内容补充
例如:
{
  "type": "PROCEDURE",
  "name": "六经辨证流程",
  "steps": [
    {
      "order": 1,
      "action": "判断表里"
    },
    {
      "order": 2,
      "action": "判断寒热"
    }
  ],
  "sources": [...]
}规则:
{
  "type": "DECISION_RULE",
  "if": [
    "..."
  ],
  "then": [
    "..."
  ],
  "exceptions": [],
  "sources": []
}现在已经越来越像:
自然语言程序。
实体归一化
现在问题出现了:
一份资料写:
桂枝汤另一份写:
桂枝湯还有:
桂枝汤方模型必须知道它们指向同一个东西。
这就是:
Entity Resolution
最终:
{
  "entityId": "formula-guizhitang",
  "canonicalName": "桂枝汤",
  "aliases": [
    "桂枝湯",
    "桂枝汤方"
  ]
}技术包括:
规则匹配
字典
Embedding similarity
LLM Entity Linking
人工审核去重
大量资料一定重复。
比如 50 节课程都解释:
太阳病不能产生:
太阳病001
太阳病002
太阳病003
...需要:
Candidate Detection
↓
相似度匹配
↓
LLM 判断
↓
Merge可以先:
Embedding cosine similarity筛候选。
然后再:
LLM判断:
same
related
conflict
different冲突检测
这是很多 Demo 根本没解决的问题。
比如资料 A:
某方剂剂量 X资料 B:
剂量 Y不要生成:
剂量 Z应该:
{
  "knowledgeId": "...",
  "status": "CONFLICT",
  "claims": [
    {
      "value": "X",
      "source": "A"
    },
    {
      "value": "Y",
      "source": "B"
    }
  ]
}然后:
人工裁决
or
保留不同版本这其实属于:
Knowledge Provenance + Truth Maintenance
建立关系
现在:
太阳病
桂枝汤
麻黄汤
恶寒
发热
汗
脉象还是散的。
需要:
Relationship Extraction例如:
太阳病
├─HAS_SYMPTOM→ 恶寒
├─HAS_SYMPTOM→ 发热
├─RELATED_FORMULA→ 桂枝汤
└─RELATED_FORMULA→ 麻黄汤可以存 PostgreSQL:
knowledge_node
knowledge_edge例如:
knowledge_node
--------------
id
type
name
attributes

knowledge_edge
--------------
source_id
relation_type
target_id
source_ref如果关系非常复杂,再考虑:
Neo4j
NebulaGraph早期完全没必要上图库。
PostgreSQL 足够。
建立 Taxonomy
建立 Taxonomy,其实就是将是指将杂乱无章的各种技能、知识点或行为规范,按照层级和逻辑关系整理成一个结构化、有条理的分类框架。关系只是局部,最终还需要形成知识分类体系。
比如中医:
中医学
├── 基础理论
│   ├── 阴阳
│   ├── 五行
│   └── 藏象
│
├── 诊断
│   ├── 望
│   ├── 闻
│   ├── 问
│   └── 切
│
├── 辨证
│   ├── 八纲
│   └── 六经
│
├── 方剂
│   ├── 桂枝汤
│   └── 麻黄汤
│
└── 医案技术:
Topic Classification
Hierarchical Clustering
LLM Taxonomy Generation
人工领域 Schema从“知识”继续蒸馏“方法论”
这才是 Skill 真正超越 RAG 的地方。
普通 RAG:
“桂枝汤是什么?”

↓
搜索
↓
回答Skill 则需要:
面对一个问题
应该:
1. 先看什么
2. 怎么判断
3. 查什么知识
4. 什么时候排除
5. 输出什么例如从大量倪海厦课程里可能抽取出:
诊断决策流程类似:
第一步:表里
↓
第二步:寒热
↓
第三步:虚实
↓
……从:
Knowledge升维为:
Procedure
Heuristic
Decision Rule
Workflow风格提炼
如果你炼的是“某个人”,还要提炼:
他说什么之外的:
他怎么说例如:
句式
术语
比喻
解释顺序
偏好的论证方式
典型表达形成:
{
  "style": {
    "tone": "...",
    "vocabulary": [],
    "patterns": []
  }
}但必须注意:
风格和事实知识必须分离。
否则:
某人习惯这么说容易被模型误认为:
事实就是这样。评测
这一层不能省。
任何 Knowledge Node 都必须:
Knowledge
↓
Chunk
↓
Document
↓
Original Source例如:
桂枝汤
↓
chunk-882
↓
伤寒论.pdf P32
↓
原始文件所以数据库关系:
knowledge_item
     │
     ▼
knowledge_source_ref
     │
     ▼
document_chunk
     │
     ▼
document这样用户以后点击:
“依据是什么?”
你能直接跳回原文。
打分、评估
模型不是数据库。
它可能抽错。
所以建议每条信息有:
confidence
verification_status例如:
{
  "confidence": 0.86,
  "verificationStatus": "AI_EXTRACTED"
}审核以后:
HUMAN_VERIFIED状态可以设计:
RAW
AI_EXTRACTED
AI_VERIFIED
HUMAN_VERIFIED
CONFLICT
REJECTED然后我们需要自动生成测试集。
例如从中医资料生成:
Q:
桂枝汤的组成是什么?

Expected:
必须命中来源 A
必须包含……
禁止出现……以及:
Q:
病人 XXX,应如何辨证?

Expected:
必须先……
不能直接……评测:
Faithfulness
Citation Accuracy
Retrieval Recall
Knowledge Coverage
Rule Accuracy
Hallucination Rate不让模型给自己打分
可以:
LLM Judge但最好再配:
确定性规则
+
Source Grounding
+
测试集
+
人工抽检例如:
模型回答方剂剂量
↓
程序直接和 Knowledge IR 比较这种指标比:
另一个 GPT 说“9 分”靠谱得多。
编译
现在终于开始生成 Skill。
输入:
Knowledge IR
Taxonomy
Procedures
Rules
Cases
StyleCompiler 输出:
nihaixia-skill/
│
├── SKILL.md
│
├── knowledge/
│   ├── diagnostics.md
│   ├── formulas.md
│   └── herbs.md
│
├── workflows/
│   └── diagnosis.md
│
├── cases/
│   └── ...
│
└── references/
└── ...但是不能把几百万字直接塞进去,因为Skill的格式更接近:
Agent Manifest
+
Router
+
Instructions
+
Knowledge Index例如:
# Role

你是……

# Reasoning Workflow

1. 判断……
2. 查询……
3. 验证……

# Knowledge Routing

询问方剂:
→ references/formulas/

询问六经:
→ knowledge/six-meridians/

询问案例:
→ cases/

# Safety

……

# Output

……因此编译的时候,最好使用 Template + LLM,比如:
模板
+
Knowledge IR
+
LLM 填充类似:
SkillCompileContext context;

SkillTemplate template;

skillCompiler.compile(context, template);这样能保证结构一致。
索引
当知识很多:
3,000 pages不可能全塞 Context。
所以编译 Skill 的同时产生:
Full Text Index
Vector Index
Metadata Index
Graph Index推荐:
全文
PostgreSQL FTS
Elasticsearch / OpenSearchVector
pgvector
Milvus如果你的平台已经准备使用 Milvus,完全可以复用。
Metadata
PostgreSQL例如:
type = FORMULA
book = 伤寒论
chapter = ...混合检索
别完全依赖向量搜索。
例如查询:
桂枝汤Keyword 明显优于 embedding。
可以:
Keyword Search
+
Vector Search
+
Graph Search
+
Metadata Filter
       ↓
Rerank这就是:
Hybrid Retrieval
Agent Runtime
最后才是:
AgentRuntime 可以有:
LLM
+
Skill
+
RAG
+
Tools
+
Memory例如用户:
“某患者出现 A、B、C……”系统:
LLM
↓
读取 SKILL.md
↓
知道应该执行六经辨证流程
↓
searchKnowledge(...)
↓
getFormula(...)
↓
searchCase(...)
↓
拿到来源
↓
按照 Skill 规定的格式输出一个完整的案例
假设输入:
《伤寒论》PDF
倪海厦伤寒论课程 100 小时视频
200 个医案
500 张讲义图片Phase 1
变成:
5 万个 DocumentBlockPhase 2
切成:
2 万个 ChunkPhase 3
LLM 抽取:
疾病概念
症状
方剂
药物
诊断规则
治疗原则
案例
人物观点可能:
30 万 Knowledge ClaimsPhase 4
Entity Resolution:
桂枝汤
桂枝湯
桂枝汤方

↓

FORMULA-0001Phase 5
Merge:
130 条描述桂枝汤的资料

↓

统一实体
+
130 个 Claims注意:
不是一定合成一个 Claim。
不同来源允许保留。
Phase 6
建立:
桂枝汤
├── ingredient
├── dosage
├── indication
├── contraindication
├── related_symptom
├── related_case
└── sourcePhase 7
从课程提炼:
倪海厦诊断方法形成:
Procedure
DecisionRule
HeuristicPhase 8
生成:
SKILL.md
references/
rules/
cases/Phase 9
产生 1000 道测试:
事实题
推理题
案例题
冲突题
陷阱题Phase 10
Evaluation 不通过:
缺失
错误
幻觉
来源不一致则:
回溯 Knowledge IR
↓
重新 Extract / Merge而不是去手工修 SKILL.md。
这一点特别重要。
系统整体架构
                           ┌──────────────┐
                           │ Raw Sources  │
                           └──────┬───────┘
                                  ▼
                         Canonical Documents
                                  ▼
                              Chunks
                                  ▼
                            Knowledge IR
                                  ▼
                      Normalize / Resolve
                                  ▼
                       Knowledge System
                                  ▼
                           Skill Compiler
                                  ▼
                              Skill
                                  ▼
                           Evaluation
                                  │
                      ┌───────────┴───────────┐
                      │ PASS                  │ FAIL
                      ▼                       ▼
                  Publish                Trace Source
                                              │
                                              ▼
                                       Fix Knowledge IR
                                              │
└──────↺核心引擎
未来做项目时,可以直接这样定边界:
| 引擎 | 功能 |
|---|---|
| Ingestion Engine | 万物接入 |
| Normalization Engine | 多模态标准化 |
| Knowledge Engine | 知识抽取/治理 |
| Ontology Engine | 关系/体系构建 |
| Skill Compiler | Skill 编译 |
| Evaluation Engine | 自动评测 |
最后配:
Agent Runtime整体就是:
           炼化万物平台

             Source
               │
               ▼
      Ingestion Engine
               │
               ▼
     Normalization Engine
               │
               ▼
       Knowledge Engine
               │
               ▼
       Ontology Engine
               │
               ▼
        Skill Compiler
               │
               ▼
      Evaluation Engine
               │
               ▼
            Registry
               │
               ▼
Agent Runtime不过,这个东西可能最终并不叫“Skill 生成器”,而应该叫最终应该是Knowledge Compiler Platform,Skill 只是 Target。
                    Claude Skill
                         ▲
                         │
                        target
                         │
Markdown ──┐             │
PDF ───────┤        ┌────┴─────┐
Image ─────┼──────→ │ Knowledge │
Audio ─────┤        │ Compiler  │
Video ─────┤        └────┬─────┘
Web ───────┘             │
                         │
        ┌────────────────┼────────────────┐
        ▼                ▼                ▼
RAG MCP Knowledge Graph但架构思想应该非常朴素:
Source → IR → Compile → Evaluate → Runtime