KAG 工程化落地:从PoC到生产架构
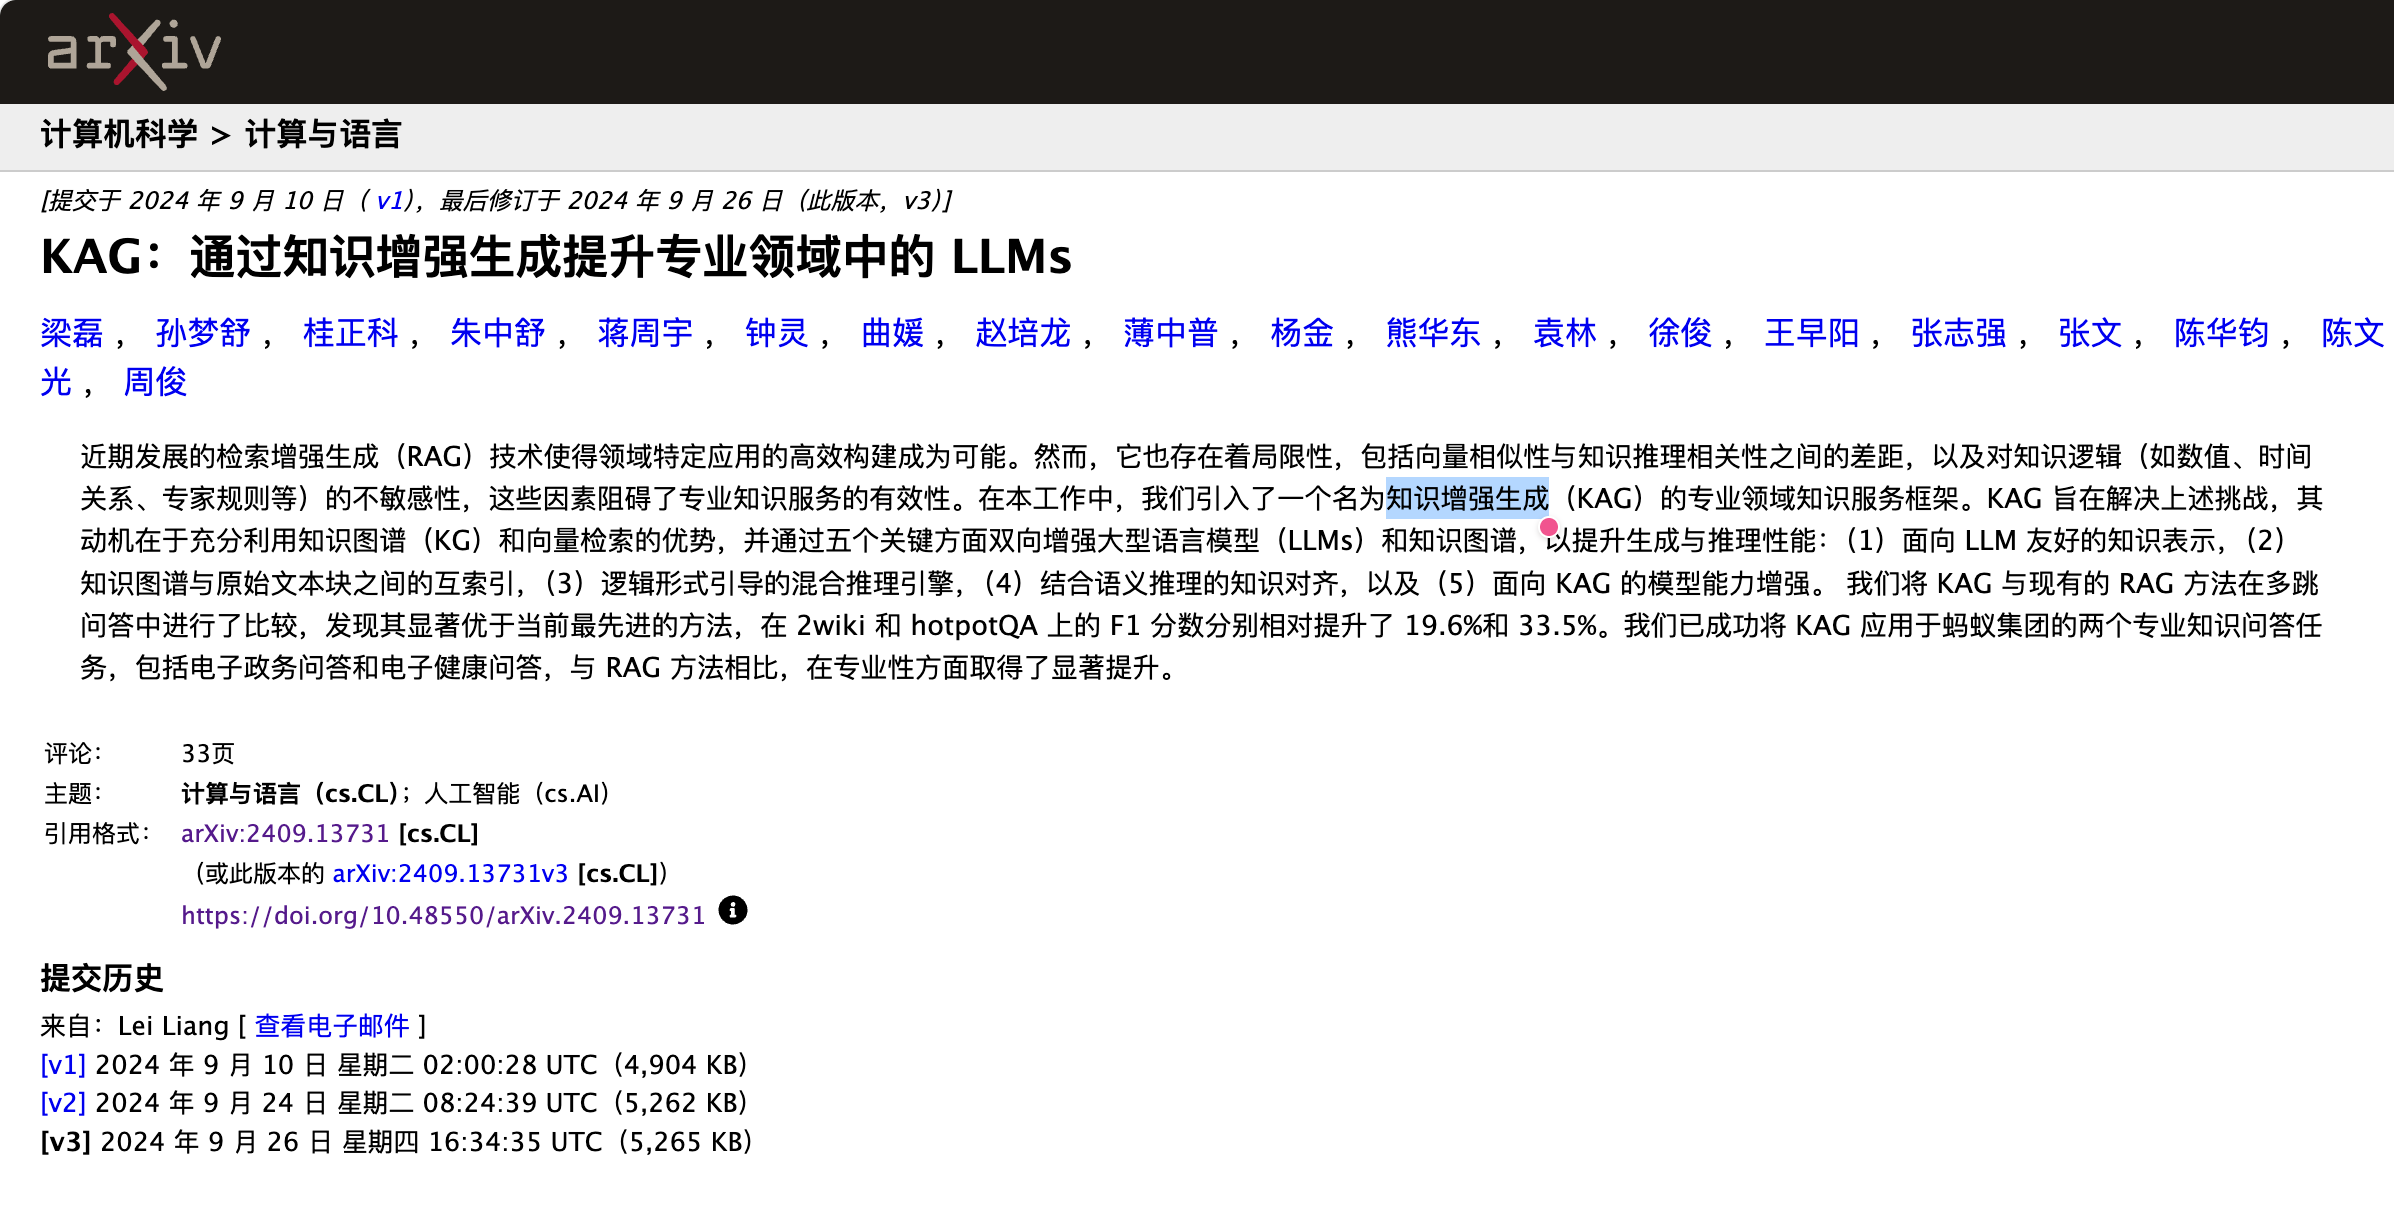
什么是KAG呢?可以看下面的回答:⬇️
这个概念最早是24年有人提出来的,它的理念是将向量检索生成强化为知识检索生成,通过引入体系化的专业知识来解决RAG在实际落地中遇到了行业知识壁垒、上下文关联不足的问题:⬇️
这正是KAG真正难的地方,它不是把某个框架跑起来,而是把知识、检索、推理和现有业务系统的边界拆清楚。如果项目本身是 Java 主业务系统,工程上更合理的思路不是把所有 AI 能力塞进 Spring Boot,而是把知识检索和推理能力独立成一个 AI Knowledge Service:Java 继续负责业务,Python 负责 AI Pipeline,图数据库和向量数据库作为基础设施存在。
我调研了一下,目前可行的有以下几套比较适合实现KAG的方案:
| 目标 | 更合适的方案 |
|---|---|
| 快速验证 Graph + Vector 是否有收益 | LightRAG |
| 长期生产、希望自己掌控架构 | LlamaIndex + Neo4j |
| 已经进入 Ontology、领域规则、复杂推理 | OpenSPG + KAG |
| 大型文档库的全局分析 | Microsoft GraphRAG |
| 多工具 Agent 编排 | LangGraph + Neo4j |
LightRAG:适合先做 PoC
LightRAG 最适合用来回答一个问题:
给现有 RAG 加上知识图谱以后,业务效果到底有没有提升?
它会从文档中抽取实体和关系,同时维护 Knowledge Graph 和 Vector Embedding,在查询时组合图检索和向量检索。
Document
   │
   ├── Chunk ── Embedding ── Vector Store
   │
   └── Entity / Relation Extraction ── Knowledge Graph
                                         │
Question ── Vector Retrieval + Graph Retrieval ── LLM对 Java 项目来说,可以直接把 LightRAG 当独立服务:
Vue
 ↓
Spring Boot
 ↓ REST
LightRAG
 ↓
Graph / Vector / LLM它的优势是部署相对简单,能够比较快地验证 GraphRAG 的业务价值。
但它也有一个比较明显的问题:图谱主要依赖 LLM 自动抽取。
例如:
A1001 温度传感器安装于 2 号生产线模型可能抽成:
A1001 → installedAt → Line2也可能抽成:
TemperatureSensor → belongsTo → ProductionLine做普通知识问答问题不大,但工业系统里的实体和关系通常有明确业务含义。如果长期让 LLM 自由建图,很容易出现 Schema 不稳定、关系命名不统一、粒度不一致的问题。
所以 LightRAG 更适合:
验证 Graph + Vector 有没有价值,而不是直接承担最终的领域知识底座。
LlamaIndex + Neo4j:更适合生产环境
如果 GraphRAG 已经验证有效,下一步更值得考虑的是 LlamaIndex + Neo4j。
这条路线最大的特点不是“功能最多”,而是架构可控。
可以把检索层拆成多个独立组件:
Question
   ↓
Retriever
   ├── VectorRetriever
   ├── GraphRetriever
   └── CypherRetriever
   ↓
Reasoning
   ↓
LLMLlamaIndex 负责检索和 LLM 编排,Neo4j 负责图数据。
这种设计比较符合传统后端系统的思路:每层职责明确,出了问题也能定位。
真正上线后需要处理的通常不是“Demo 能不能跑”,而是这些事情:
- 一次回答用了哪些数据;
- Vector Retrieval 和 Graph Retrieval 分别召回了什么;
- Cypher 查询是否正确;
- 图关系错了怎么修;
- Prompt 或模型升级后结果有没有回归;
- 某类问题应该走 SQL、Graph 还是 Vector;
- 如何做日志、监控、权限和审计。
自己组装虽然开发成本高一点,但生产环境更容易控制。
OpenSPG + KAG:适合领域知识基础设施
OpenSPG + KAG 更适合另外一个阶段:系统已经不只是“知识问答”,而是开始建设长期维护的领域知识体系。
它关注的是:
Schema
Entity
Relation
Rule
Knowledge Graph
Logical Form
Multi-hop Reasoning例如工业场景:
设备
├── 属于 → 产线
├── 安装于 → 车间
├── 产生 → 指标
└── 触发 → 告警

产线
├── 负责人 → 人员
└── 属于 → 工厂用户问:
杭州工厂昨天发生温度异常的设备分别属于哪些产线,产线负责人是谁?
这类问题已经不是简单找一段文档,而是典型的领域关系查询和多跳推理。
OpenSPG KAG 的价值就在这里。
但代价也很直接:系统重。
它更像完整的知识基础设施,而不是一个装完依赖就可以工作的 RAG 库。
如果只是做企业 PDF 问答,上这一套明显过度;如果系统准备长期管理设备、资产、人员、组织、产线、指标、告警、工单和规则,那它才开始真正匹配。
工业系统的关键:结构化数据不要让 LLM 重新“猜”
工业场景里,最容易走偏的一步是:
明明数据库里已经有明确关系,还把数据转成文本,再让 LLM 抽一遍实体和关系。
如果业务库里已经有:
device
device_template
device_metric
production_line
organization
user
alarm
work_order这些表之间的外键关系,本身就是一张隐式知识图谱。
例如:
device.production_line_id本质上就是:
(Device)-[:BELONGS_TO]->(ProductionLine)再比如:
production_line.responsible_user_id可以直接映射为:
(ProductionLine)-[:RESPONSIBLE_BY]->(Person)这种关系应该由业务系统直接同步到 Neo4j,而不是让 LLM 再解释一次。
PostgreSQL
    ↓
结构化同步
    ↓
Neo4jLLM 更适合处理那些天然没有结构的数据,例如:
设备说明书
运维手册
维修记录
规章制度
技术文档这些内容再走传统文档处理链路:
Document
   ↓
Chunk
   ↓
Embedding
   ↓
Vector DB最终形成两类知识来源:
                 Structured Data
                       ↓
                 Knowledge Graph
                       ↓
Question ── Hybrid Retrieval ── Reasoning ── LLM
                       ↑
                   Vector DB
                       ↑
Documents这比“所有东西都交给 LLM 自动建图”稳定得多。
业务系统和AI服务怎么拆
对于 Java 主业务系统,不建议让 Spring Boot 自己承担 Embedding、知识抽取、图检索和 LLM 推理。
更合理的架构是:
                       前端
                        │
                   Spring Boot
                        │
        ┌───────────────┼───────────────┐
        │               │               │
       数据库           缓存           图数据库
                                        │
                              AI Knowledge Service
                                        │
                 ┌──────────────────────┼──────────────────────┐
                 │                      │                      │
             向量嵌入                  图检索                大语言模型
                 │                      │                      │
                 └──────────────────────┼──────────────────────┘
                                        │
推理AI Knowledge Service 可以使用:
Python
FastAPI
LlamaIndex / KAGSpring Boot 继续负责:
- 用户、鉴权、权限和租户;
- 业务对象和数据一致性;
- API、任务和服务编排;
- 审计和业务日志。
Python AI Service 负责:
- Embedding;
- Knowledge Extraction;
- Vector Retrieval;
- Graph Retrieval;
- Reasoning;
- LLM。
这样做的核心价值是解耦。
以后替换 LLM、Embedding Model、Vector DB,甚至把 LlamaIndex 换成别的框架,都不需要重构 Java 主业务。
Java 层只依赖一个稳定接口即可:
public interface KnowledgeReasoningService {

    KagAnswerResp ask(KagQuestionReq req);

}底层实现只需要调用 AI Knowledge Service:
@Service
@RequiredArgsConstructor
public class KnowledgeReasoningServiceImpl
        implements KnowledgeReasoningService {

    private final KagClient kagClient;

    @Override
    public KagAnswerResp ask(KagQuestionReq req) {
        return kagClient.reason(req);
    }
}Microsoft GraphRAG 和 LangGraph 放在哪里
这两个技术值得知道,但不需要放到主路线里。
Microsoft GraphRAG
它更适合大型文档库的全局分析。
例如有几万篇新闻、报告或论文,需要回答:
过去一年这个行业主要发生了哪些变化?
它会围绕 Knowledge Graph、Community Detection 和 Community Summary 做全局理解。
所以它适合“大量文档整体在讲什么”,而不是“设备 A 属于哪条产线”这种明确业务关系查询。
LangGraph
LangGraph 更适合做 AI Application Orchestration。
例如:
Question
   ↓
Planner
   ↓
选择工具
   ├── Vector DB
   ├── Neo4j
   ├── SQL
   └── HTTP API
   ↓
Reasoning它可以参与 KAG,但它本身不提供完整的 Knowledge Graph、Schema 和领域知识体系。
所以更适合把它放在编排层,而不是当成 KAG 的核心知识底座。
推荐的实际落地路线
如果项目现在刚开始做,不建议直接上完整 KAG。
更稳妥的路线是三步。
PoC:先证明 GraphRAG 有价值
LightRAG
+
Neo4j / PostgreSQL
+
OpenAI-compatible LLM这一阶段只看一个指标:
Graph + Vector Hybrid Retrieval 是否比原来的纯 RAG 明显更好。
不要急着做复杂 Ontology,也不要先造一堆基础设施。
生产化:把检索链路掌握在自己手里
验证有效之后,再切到:
FastAPI
+
LlamaIndex
+
Neo4j
+
Qdrant / Milvus自己控制:
Graph Retriever
Vector Retriever
Hybrid Retriever
Cypher Retriever
Reasoning同时补齐监控、日志、权限、数据同步、模型配置和查询追踪。
这一层比较适合作为长期生产架构。
领域 KAG:业务需要时再上 OpenSPG
只有当系统已经明确需要:
工业 Ontology
领域 Schema
专家规则
复杂多跳推理
知识对齐
领域约束再考虑:
OpenSPG
+
KAG到了这一步,项目建设的已经不是“一个更强的 RAG”,而是一套领域知识基础设施。
最终选型
可以直接按下面这个判断:
先验证 Graph + Vector
        ↓
     LightRAG

需要生产级、自主可控
        ↓
LlamaIndex + Neo4j + FastAPI

业务进入 Ontology / Rule / Complex Reasoning
        ↓
OpenSPG + KAG如果是 Java 后端主导的工业平台,生产方向更适合:
Spring Boot
    +
FastAPI AI Knowledge Service
    +
Neo4j
    +
Vector DB
    +
LlamaIndexLightRAG 用来快速 PoC,OpenSPG KAG 留到真正需要领域 Ontology 和规则推理时再引入。
核心原则只有一个:
先证明知识图谱对业务有收益,再建设知识基础设施。